

Die Wissenschaft des Klangs: Wie audiovisueller Input den Spracherwerb transformiert
Seit Jahrzehnten ahnen Sprachlernende, dass das Ansehen eines fremdsprachigen Films effektiver wirkt als das bloße Hören eines Podcasts. Nun bestätigt und quantifiziert eine umfassende Meta-Analyse, veröffentlicht in Studies in Second Language Acquisition von Tetyana Sydorenko und Kollegen, genau diese Intuition. Die Studie mit dem Titel „Effects of Audiovisual Input on Second Language Learning: A Meta-Analysis" bündelt Daten aus Dutzenden empirischen Untersuchungen und liefert damit den bislang umfassendsten Nachweis: Man lernt tatsächlich besser, wenn man sehen kann, was man hört.
Die Kernfrage ist trügerisch einfach. Wenn Lernende ein Video ansehen, in dem Laute mit sich bewegenden Lippen, Mimik und kontextuellen Bildern verschmelzen, erwerben sie dann Vokabeln und Grammatik leichter, als wenn sie nur den Ton gehört hätten? Die Antwort, gestützt durch rigorose statistische Analysen, ist ein eindeutiges Ja. Dieser Beitrag entschlüsselt die Ergebnisse der Studie, erklärt die zugrunde liegenden kognitiven Mechanismen und bietet ein praktisches, videobasiertes Protokoll, das Sie bereits heute Abend anwenden können, um Ihren Lernprozess mit Werkzeugen zu beschleunigen, die genau für diesen Zweck entwickelt wurden.
Die Meta-Analyse im Detail: Was wurde gemessen?
Eine Meta-Analyse ist kein einzelnes Experiment. Sie ist eine Studie über Studien, die Ergebnisse systematisch kombiniert, um übergreifende Trends zu identifizieren. Sydorenko und ihr Team durchforsteten die Fachliteratur nach Untersuchungen, die audio-only (AO) und audiovisuellen (AV) Input im Kontext des Zweitspracherwerbs direkt miteinander verglichen. Nach einem strengen Auswahlverfahren synthetisierten sie Daten aus 59 unabhängigen Stichproben, die Lernende verschiedener Erst- und Zweitsprachen, darunter Englisch, Spanisch und Französisch, umfassten. Die Analyse konzentrierte sich auf drei zentrale Ergebnisbereiche: Wortschatzerwerb, Hörverständnis und grammatische Entwicklung.
Das entscheidende Ergebnis war nicht nur, dass Videos helfen, sondern wie stark sie helfen. Das Lernen mit Bildschirmtext (Untertiteln) zusätzlich zum Video ergab eine Effektstärke (g = 0,63), die deutlich größer war als bei Videos ohne Untertitel (g = 0,39). Dies zeigt eine klare Hierarchie der Input-Effektivität.
Die Forschenden suchten nicht nur nach einem allgemeinen „AV-Boost". Sie untersuchten entscheidende Moderatoren, jene situativen Faktoren, die den Lerneffekt verstärken oder abschwächen können. Dazu gehörten das Vorhandensein von Untertiteln, die Art des Videos (eine dynamische Filmszene vs. ein statischer Vortrag), das Sprachniveau der Lernenden und das Lernziel (einzelne Wörter vs. grammatische Strukturen). Dieser granulare Ansatz führt die Diskussion von einem vagen „Fernsehen ist gut für dich" zu einem präzisen, evidenzbasierten Rahmenwerk für die Optimierung von Input.
Warum Sehen Überzeugen Schafft: Die Kognitionswissenschaft des Dualen Kodierens
Der kognitive Vorteil audiovisuellen Inputs wird elegant durch Allan Paivios Theorie des dualen Kodierens erklärt. Dieses Modell postuliert zwei getrennte, aber miteinander verbundene Kanäle der Informationsverarbeitung: einen verbalen Kanal für Sprache und einen nonverbalen Kanal für Bilder und visuelle Hinweise. Wenn Sie nur das Wort correr (laufen) hören, verarbeiten Sie es über einen einzigen Kanal. Wenn Sie jedoch eine Szene ansehen, in der eine Figur dringend „¡Corre!" ruft, während sie durch einen überfüllten Markt sprintet, kodiert Ihr Gehirn das Wort gleichzeitig über beide Kanäle. Dies erzeugt zwei getrennte Gedächtnisspuren für dasselbe lexikalische Element und bildet ein reichhaltigeres, redundanteres Netzwerk, das deutlich resistenter gegen Vergessen ist.
Das Gehirn ist darauf ausgelegt, reichhaltigere und redundantere Gedächtnisspuren zu bilden, wenn es Klang und Bild miteinander verknüpft – dies ist die biologische Grundlage dafür, dass ein in einer Filmszene gehörtes Wort besser haftet als eine Vokabelkarte.
Dieser Prozess wird zusätzlich durch das verstärkt, was die Forschenden als „bildauslösenden Input" bezeichnen. Dynamischer visueller Input ist nicht nur ergänzend; er reduziert aktiv die kognitive Belastung. Betrachten Sie es so: Eine rein auditive Beschreibung einer komplexen Szene zwingt Ihr Gehirn dazu, wertvolle mentale Energie für den Aufbau eines visuellen Modells aufzuwenden. Video liefert dieses Modell kostenlos mit und setzt kognitive Ressourcen frei, die sich auf das Verarbeiten der Sprache selbst konzentrieren können. Lernende, die einen solchen geordneten, kontextualisierten Input erhalten, benötigen eine ausreichende Informationsakkumulation, bevor ihre adaptive Kapazität greift, und die potenziellen Folgekosten des Lernens aus ungeordnetem, dekontextualisiertem Material sind messbar höher.
Die entscheidende Rolle von Untertiteln und Untertiteltypen
Die Meta-Analyse bringt bemerkenswerte Klarheit über die Rolle des Bildschirmtexts. Ein Video ohne Untertitel bietet zwar kraftvolle kontextuelle Bilder, aber auch eine entmutigende Wand aus muttersprachlichem Sprechtempo. Untertitel schließen diese Lücke, indem sie einen präzisen orthografischen Anker für den phonologischen Strom liefern. Die Studie fand heraus, dass die größten Wortschatzgewinne aus dem stammen, was viele Lehrende als „bimodalen Input" bezeichnen: ein Wort in der Zielsprache zu lesen, während man es gleichzeitig hört.
Diese Unterscheidung eröffnet einen kraftvollen, abgestuften Ansatz für die Verwendung von Videos im Unterricht oder beim Selbststudium. Lernende können eine Abfolge von Input-Modidurchlaufen, die jeweils ein anderes Maß an Unterstützung bieten:
- Volle Unterstützung: Untertitel in der Zielsprache + Video. Verbindet Klang, Schreibweise und visuellen Kontext.
- Mittlere Herausforderung: Untertitel in der Muttersprache + Audio in der Zielsprache. Paart neue Klänge mit vertrauten Bedeutungen für das Verständnis.
- Abruf-Test: Video ohne Untertitel. Zwingt das Gehirn, Sprache in Echtzeit zu dekodieren und zu verarbeiten – simuliert reales Zuhören.
Werkzeuge, die es Lernenden erlauben, fließend zwischen diesen Modi zu wechseln, verwandeln eine passive Sehsitzung in ein bewusstes Übungstraining. Wenn Sie ein zweisprachiges Untertitelpaar umschalten können und dabei die Zielsprache und eine sofortige Übersetzung sehen, wandeln Sie systematisch unverständlichen Input in verstandene Aufnahme um.
Über den Wortschatz hinaus: Die Übertragung auf Hörverständnis und Grammatik
Obwohl der Wortschatz das am häufigsten untersuchte Ergebnis ist und den robustesten AV-Effekt zeigt, untersuchte die Meta-Analyse auch das Hörverständnis und die grammatische Entwicklung. Der Effekt auf das Hörverständnis (g = 0,40) war signifikant, aber etwas kleiner als beim Wortschatz. Das leuchtet intuitiv ein. Verständnis ist eine komplexe, vielschichtige Fähigkeit; eine kurzfristige AV-Intervention kann schnell ein kontextuelles Netzwerk für ein Nomen aufbauen, aber die Neuverdrahtung der globalen auditiven Verarbeitungsgeschwindigkeit des Gehirns erfordert massive Exposition. Video bietet die „Zeitlupen-Übung", die es Ihnen ermöglicht, Prosodie, den Rhythmus, die Betonung und die Intonation der Sprache, auf sichtbare Gesten und Gesichtsausdrücke abzubilden.
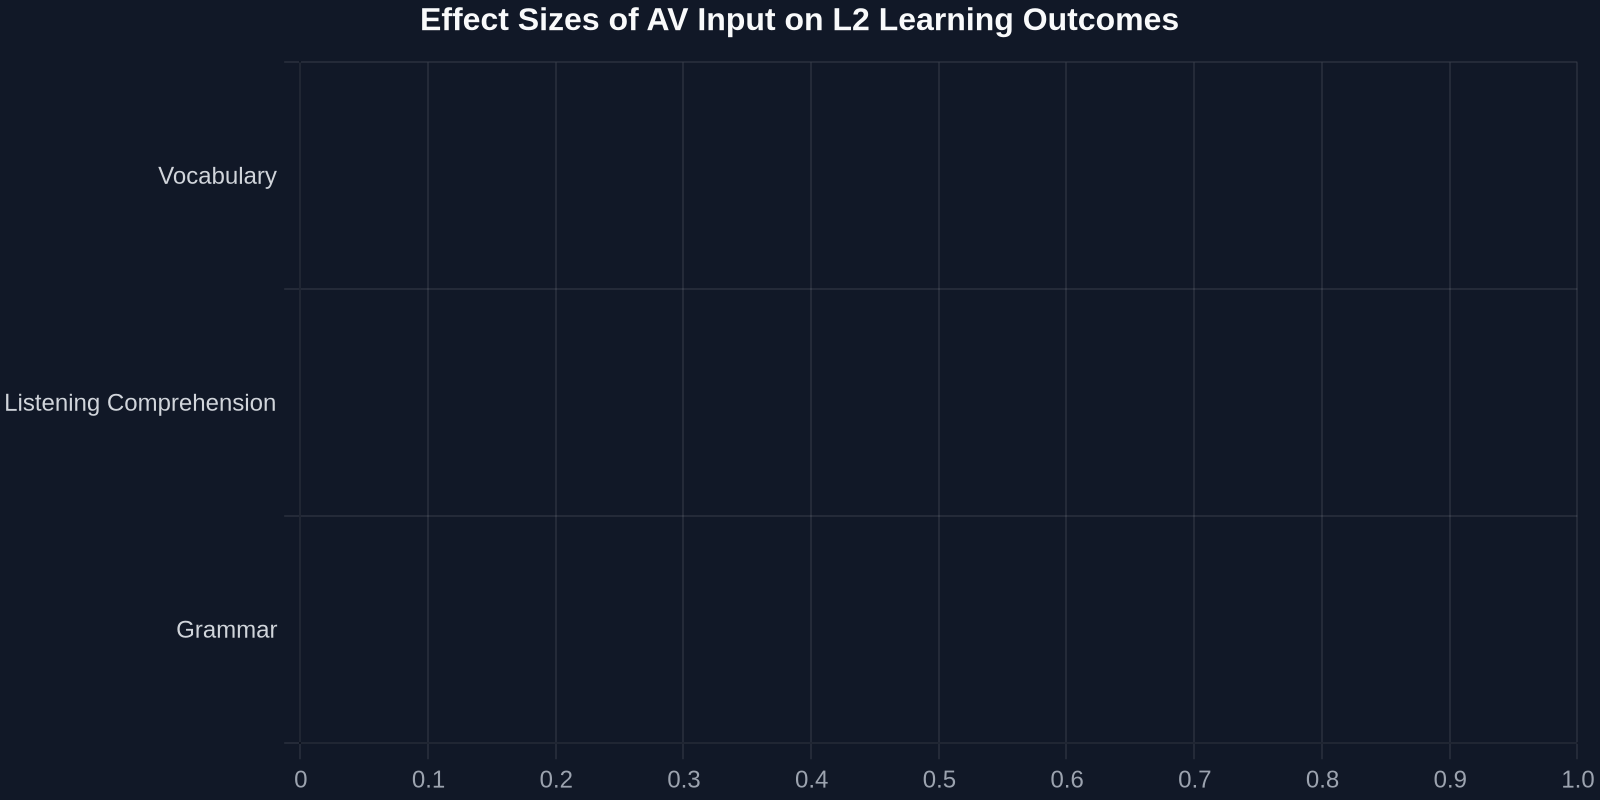
Auch grammatikalische Fortschritte waren erkennbar, wenn auch differenziert. Die Effektstärke für Grammatik (g = 0,39) war signifikant, jedoch war die Anzahl der Studien geringer. Video scheint besonders hilfreich für Strukturen zu sein, die sich in einem Lehrbuch nur schwer veranschaulichen lassen, aber visuell leicht darstellbar sind, wie Präpositionen des Ortes oder der Verlaufsform. Ein Satz wie „She’s putting it on the table“ wird grammatikalisch transparent, wenn man die Handlung ablaufen sieht. Die Studie legt nahe, dass AV-Input ein mächtiges Werkzeug ist, um intuitive, gebrauchsbasierte grammatikalische Kompetenz aufzubauen, die nicht aus dem Auswendiglernen von Regeln entsteht, sondern aus dem Sehen tausender korrekter Beispiele im lebendigen Kontext.
Das praktische Protokoll: Vom passiven Anschauen zur aktiven Aneignung
Die Forschung zu kennen ist das eine; sie in einen vollen Alltag zu integrieren, ist eine andere Sache. Die Stärke der Lyric Lingo-Plattform liegt darin, dass sie genau diese Wissenschaft in die Videos einbaut, die du ohnehin gerne auf YouTube ansiehst. Du musst keine spezialisierten, oft langweiligen Bildungsinhalte suchen. Jedes Musikvideo, jeder Vlog oder Kurzfilm wird zu einem strukturierten Lerntext. Hier ist ein Drei-Durchgänge-Protokoll, direkt inspiriert von der Metaanalyse, das du heute Abend mit einem einzigen Musikvideo anwenden kannst.
Durchgang 1: Verständniskartierung (4-5 Minuten)
Einrichtung: Aktiviere zweisprachige Untertitel. Spiele das gesamte Video ohne Pause ab. Dein Ziel hier ist nicht das Auswendiglernen, sondern entspanntes, kontextreiches Verständnis. Folge einfach der Geschichte oder dem emotionalen Bogen des Liedes. Wenn eine Zeile wie „Je te laisserai des mots“ (I will leave you notes) in einem Patrick Watson-Video erscheint, gibt dir die L1-Übersetzung sofortige Bedeutung, während das Bild eines gemütlichen Zimmers den intimen, melancholischen Ton des Satzes kodiert. Du baust das anfängliche mentale Modell auf und lässt die Mustererkennungssysteme des Gehirns unbewusst beginnen, den Sprachstrom zu segmentieren.
Durchgang 2: Fokussiertes Chunking (10-15 Minuten)
Einrichtung: Immer noch mit zweisprachigen Untertiteln, aber jetzt behandelst du das Video wie ein Forscher. Arbeite Satz für Satz durch die erste Strophe und den Refrain. Spiele einen kurzen Abschnitt erneut ab, eine einzelne Zeile oder sogar einen Teilsatz. Höre noch einmal zu, während du nur den Text in der Zielsprache liest. Versuche, den Sänger zu echoen, den Satz zu schatten, indem du seine genaue Aussprache und Intonation nachahmst. Wenn du auf ein unbekanntes Wort stößt, das dir wichtig erscheint, schalte den Untertitel um, um es isoliert anzuzeigen. Der Schlüssel hier ist bewusstes Wahrnehmen. Du bewegst den Wortschatz von „vage vertraut“ zu „explizit bekannt“ und schaffst die mentalen Verbindungen, die die Dual-Coding-Theorie verlangt.
Durchgang 3: Abruf und Darbietung (5 Minuten+)
Einrichtung: Wechsle zu Untertiteln nur in der Zielsprache, oder schalte sie für den Refrain ganz aus, wenn du mutig bist. Spiele den Abschnitt erneut ab. Kannst du die Kernbedeutung immer noch erfassen? Dieser letzte, ungestützte Durchgang ist der Ort, an dem Anstrengung produktiv wird. Die leichte Schwierigkeit signalisiert deinem Gehirn, dass diese Informationen es wert sind, behalten zu werden. Sie spricht direkt die Erkenntnis der Metaanalyse an, dass ein gewisses Maß an Herausforderung im Input größere Anstrengung und tiefere Verarbeitung aktiviert und die Abrufpfade für Gespräche in der realen Welt festigt.
Unterschätze nicht die Kraft des letzten Abrufdurchgangs. Die Forschung legt nahe, dass die Anstrengung, die erforderlich ist, um ohne Unterstützung zu verstehen, das neurologische Äquivalent einer letzten Versiegelungsschicht auf einer frisch gebauten Erinnerung ist.
Videos für optimales Lernen auswählen: Eine linguistische Checkliste
Nicht jeder audiovisuelle Input ist gleich. Die Metaanalyse deutet darauf hin, dass dynamische, erzählerisch reiche Videos tendenziell stärkere Effekte erzielen als statische „Talking-Head“-Vorträge. Um deinen ROI (Return on Investment) deiner Lernzeit zu maximieren, sei selektiv. Wende diese Checkliste an, wenn du ein YouTube-Video für deine nächste Sitzung auswählst:
- Sprache-Bild-Korrelation: Die goldene Regel. Klärt das, was du siehst, direkt das, was du hörst? Eine Kochshow, in der der Koch sagt „I’m mincing garlic“ (Ich hacke Knoblauch), während er die Handlung ausführt, ist perfekt. Ein Musikvideo mit abstrakten Bildern und metaphorischen Texten ist viel schwieriger.
- Lexikalische Dichte: Für Lernende auf mittlerem Niveau ist ein Video, das in einem Zeitraum von 3 Minuten 5-7 neue Wörter einführt, ein optimaler Bereich. Lyrikbasierte Videos sind hier außergewöhnlich, weil Lieder typischerweise wiederholte Refrains haben, die dir mehrere natürliche Expositionen zu hochwertigem Wortschatz bieten.
- Paralinguistischer Reichtum: Achte auf sichtbare Gesichter. Wir sind evolutionär darauf vorbereitet, Lippen und mikroskopische Gesichtsausdrücke zu lesen. Videos, die Nahaufnahmen von Sängern oder Schauspielern zeigen, liefern einen Hauch von stiller Sprachinformation, die die Phonemwahrnehmung verbessern kann.
- Authentisches Tempo und Rhythmus: Musik ist besonders wirkungsvoll. Der Rhythmus und die Melodie eines Liedes bieten eine mnemonische Struktur, die die auditive Verarbeitungslast drastisch reduziert und als Gerüst fungiert, das die Wörter tiefer in das prozedurale Gedächtnis trägt.
Den Skeptiker ansprechen: Ist das nur „Spaß“ oder echtes Lernen?
Ein häufiger, anhaltender Zweifel unter ernsthaften Lernenden ist, dass die Verwendung von Musik und Videos zu angenehm ist, um effektiv zu sein. Diese Sorge spiegelt eine veraltete „No pain, no gain“-Sichtweise der Bildung wider. Die Metaanalyse räumt diese Vorstellung leise aus dem Weg. Die messbaren Effektstärken für AV-Input sind nicht trivial. Um den Effekt von g=0,63 für untertitelte Videos in Perspektive zu setzen: Er liegt genau im Bereich vieler angesehener pädagogischer Interventionen in der Bildungsforschung. Es ist ein substanzieller, bildungspolitisch bedeutsamer Schub.
Der Faktor des emotionalen Engagements ist weit davon entfernt, eine Ablenkung zu sein, sondern tatsächlich ein Kernbrennstoff für das Lernen. Die Amygdala, das emotionale Zentrum unseres Gehirns, moduliert die Stärke der hippokampalen Gedächtniskonsolidierung. Wenn du von der Melodie eines Liedes bewegt oder von der Erzählung eines Vlogs gefesselt bist, ist deine Neurochemie darauf vorbereitet, den sprachlichen Input zu kodieren. Ein Lernender, der sich emotional mit „A Dios le pido“ von Juanes verbindet, lernt nicht nur den Subjunktiv; er bettet die Struktur in ein Netzwerk aus Gefühl, Erinnerung und kulturellem Kontext ein. Dies schafft einen lexikalischen Gegenstand, der unendlich viel abrufbarer ist als einer, der aus einer trockenen Liste auswendig gelernt wurde.
Das emotionale Feuer, das ein kraftvolles Lied entfacht, ist keine Ablenkung vom Lernen, sondern ein Katalysator, der Vokabeln in das Langzeitgedächtnis einbrennt.
Integration von audiovisuellem Input in eine ausgewogene Lernernährung
Die Metaanalyse von Sydorenko sollte nicht als Aufruf verstanden werden, Lehrbücher, Tutoren oder Sprechpraxis aufzugeben. Vielmehr weist sie auf einen optimierten Inputstrom hin. Betrachte die 80/20-Regel: Für viele Lernende auf mittlerem Niveau kann ein Verhältnis von 80% verständlicher, inputreicher Aktivität (ausgiebiges Anschauen und Zuhören) zu 20% bewusstem, analytischem Studium (Grammatikübungen, intensives Lesen) transformativ sein. Audiovisueller Input ist die Brücke, die massiven Input für erwachsene Lernende möglich und nachhaltig macht, die die kontextuelle Hilfe benötigen, die Kinder von Natur aus erhalten.
Hier ist, wie eine optimierte, wissenschaftlich gestützte Lernwoche aussehen könnte:
- Tägliche Mikro-Sitzung (10 Min.): Ihr morgendliches Kaffeeritual. Schauen Sie sich ein einzelnes Musikvideo mit dem Drei-Durchgänge-AV-Protokoll auf Lyric Lingo an. Konzentrieren Sie sich auf verständliches Mapping und das Chunking einer einzelnen neuen Phrase.
- Wöchentlicher Deep Dive (45 Min.): Wählen Sie einen längeren Vlog oder ein kurzes Filmsegment. Wenden Sie das gleiche Protokoll an, aber fügen Sie eine Übung nach dem Ansehen hinzu: Schreiben Sie eine kurze, 30-sekündige gesprochene Zusammenfassung des Videoinhalts und versuchen Sie, drei Ihrer neu erworbenen Phrasen zu verwenden.
- Passive Verstärkung (20 Min.): Hören Sie sich das Audio der Videos, an denen Sie diese Woche gearbeitet haben, erneut an. Da der visuelle Kontext bereits in Ihrem Gedächtnis verankert ist, können Sie jetzt Ihr Gehör beim Pendeln oder beim Training ohne Bildschirmabhängigkeit trainieren.
Die Zukunft des Inputs: Datenverarbeitung, Analyse und Anpassung
Mit Blick auf die Zukunft wird das wahre Potenzial dieser Forschung durch intelligente, adaptive Plattformen erschlossen. Die Metaanalyse erwähnt die Bedeutung der „Input-Anpassung“, bleibt aber eine technologische Lösung schuldig. Dies deutet auf eine Grenze der Datenverarbeitung hin, bei der ein Tool nicht nur ein Video abspielt, sondern Ihre Interaktion damit analysiert. Datenverarbeitung, Analyse und adaptive Input-Dienste sind der nächste logische Schritt. Wie lange haben Sie bei einem bestimmten Untertitelpaar pausiert? Welche Wörter haben Sie mehrmals nachgeschlagen? Das ist nicht nur Analytik; es ist das Rohmaterial für einen personalisierten Lernalgorithmus.
Eine wirklich intelligente AV-Plattform könnte automatisch den Schwierigkeitsgrad des Inhalts anpassen, eine geführte Wiederholung Ihrer zuvor gespeicherten Wörter einfügen, direkt bevor Sie ein neues verwandtes Video ansehen, und die L1-Unterstützung schrittweise ausblenden, wenn Ihre Verständniswerte steigen. Die Fähigkeit, die eigene Betrachtungsgeschichte eines Lernenden in einen datengesteuerten Lehrplan zu verwandeln, macht YouTube von einer informellen Ressource zu einem leistungsstarken, strukturierten Bildungswerkzeug.
Wichtige Erkenntnisse für den selbstgesteuerten Lerner
Die Metaanalyse von Sydorenko et al. liefert eine definitive Antwort auf eine praktische Frage. Audiovisueller Input ist nicht nur Unterhaltung; er ist ein kognitiv privilegierter Weg zum Spracherwerb. Die Beweislage ist klar: Videos mit Untertiteln, insbesondere wenn sie bewusst eingesetzt werden, führen zu deutlich besseren Wortschatz- und Verständnisergebnissen als Audio allein. Die duale Kodierung von Ton und Bild erzeugt eine tiefere, haftenbleibende Gedächtnisspur. Der emotionale und narrative Kontext reduziert die wahrgenommene Anstrengung des Lernens und macht Beständigkeit, das wahre Geheimnis der Sprachbeherrschung, unendlich erreichbarer.
Der Weg vom Anfänger zum fließend Sprechenden ist mit Tausenden von Stunden Exposition gepflastert. Die Qualität dieser Exposition ist entscheidend. Indem Sie einen Teil Ihres täglichen Medienkonsums auf bewusste, gestützte AV-Praxis mit Werkzeugen wie Lyric Lingo verlagern, schauen Sie nicht nur mehr; Sie lernen mehr, aus jedem einzelnen Video.
Heute Abend: Schauen Sie nicht einfach ein Video an. Arbeiten Sie damit. Lassen Sie die Wissenschaft von Klang und Bild für sich arbeiten.